福原玄|計算論的精神医学(CPSY)研究者
NCNP共同研究者/日本語会話における相互行為特徴量の定量化/会話相互行為計測ツール Turn Lens 開発
日常会話における人と人の相互行為を、定量的かつ再現可能に測れるか。
この一点を追っています。
研究者としての立場
福原玄です。計算論的精神医学(CPSY: Computational Psychiatry)を専門とする研究者です。「日常会話における人と人の相互行為を、定量的かつ再現可能に測れるか」という一点を追ってきました。
2025年11月からはNCNP(国立精神・神経医療研究センター)共同研究者として、「日本語会話における相互行為特徴量の定量化指標」の研究リードを務めています。日本語日常会話コーパス(CEJC)から4カテゴリ19の相互行為特徴量を定義し、まずコーパス基本情報(性別・年齢)との関連から、次に4つの大規模言語モデル(LLM)が推定したBig Five性格スコアとの関連から、指標の妥当性を段階的に検証しています。
重視しているのは新しさより手続きの厳密さです。Ridge回帰、置換検定5,000回、Bootstrap分散分析500回、感度分析、性別・年齢の同時投入による交絡統制、そして自分の結果を反証するために設計したベースライン条件。Holm補正後、Big Five の5次元すべてで有意な関連が得られました(rfold = 0.254–0.517)。最も高いのは協調性(A, r = 0.517, 補正後 p = 0.0020)です。
ただし決定係数は 0.072–0.182 にとどまります。これは「関連がある」ことを示す結果であって、個人のスコアを言い当てられる精度ではありません。外向性(E)は補正後 p = 0.0472 と有意水準の直下にあり、正則化パラメータの選択にも依存するため、関連の有無の判定自体を保留しています。
この計測パイプラインは「Turn Lens」というツールになりました。その開発を主題とした演題が、第13回成人発達障害支援学会 高知大会(2026年9月)でポスター発表として採択されています。
研究:相互行為特徴量の定量化
Lead lea × NCNP 共同研究「日本語会話における相互行為特徴量の定量化指標」。会話分析で質的に記述されてきた現象を、大規模コーパスに対して定量的・再現可能に計測する指標セットとして体系化しています。
間・ギャップ系
発話率、沈黙長、応答の間(応答潜時)、重なり率、沈黙長の変動性。会話のテンポそのものを捉えます(8指標は先行研究由来、沈黙長の変動係数のみ本研究で新規定義)。
フィラー使用系
フィラー出現発話率、100字あたりのフィラー率。言い淀みの使用傾向を捉えます(コード上の識別子は FILL_)。
連鎖組織系
修復開始率、質問直後の修復開始率、YES/NO応答率、語彙的重なり。隣接ペアと修復連鎖の組織化を捉えます(5指標すべて本研究で新規定義。コード上の識別子は IX_)。
応答型系
終助詞(「ね」等)に対する応答の型。相槌の偏りなど日本語固有の相互行為を捉えます(3指標すべて本研究で新規定義。コード上の識別子は RESP_)。
(Classical 10 / Novel 9)
(会話×話者)
(66会話)
(IPIP-NEO-120)
手続き
新しさより手続きの厳密さを優先します。以下はすべて、結果を強く見せるためではなく、結果を疑うために置いた手続きです。
- データ選定:CEJC の自宅・2者間会話140件を会話×話者の378レコードに展開し、発話ペア数 ≥80/文字数 ≥2,000/質問直後ペア数 ≥10 をすべて満たす120レコードのみを採用(258レコードを除外)。
- リーク統制:Ridge回帰(α = 100)を GroupKFold による subject-wise split の5-fold CV で評価。同一話者が訓練foldと検証foldに跨らないことを担保。欠損補完と標準化も各foldの訓練部分のみで推定。
- 交絡統制:説明変数は相互行為特徴量19個に性別・年齢を加えた21変数。主モデル自体に人口統計学的属性を同時投入しているため、報告している関連はすべて属性を統制した上での関連です。
- 置換検定:5,000回。モデル全体の相関係数と個別回帰係数の両方を検定。
- 多重比較補正:Big5 の5次元=5回の並行検定として Holm-Bonferroni 法を適用。
- 係数安定性:Bootstrap 500回で回帰係数の SD と 95%CI を算出。置換検定とBootstrapの両方を満たす特徴量のみを「両手法支持特徴量」として扱います。
- 判定基準の厳しさの開示:Bootstrap の95%CIのみを基準にすると28個、置換検定のみでは20個、双方を要求すると18個が同定されます。どの基準を採ったかで結論が変わる範囲を明示しています。
- 感度分析:正則化パラメータ α = 10 / 50 / 100 / 200 / 500 で結果の安定性を確認。C・E・A は rfold の変動が0.04以内、O は α とともに緩やかに低下(0.421→0.380)、N は逆に上昇(0.315→0.424)。O・C・A・N は全範囲で有意。E のみ α = 10 で有意水準に達さず(pHolm = 0.056)、α 依存であることを明記。
- CV設計の比較:subject-wise split(GroupKFold)と通常のKFoldを比較。O(0.401→0.481)・A(0.517→0.538)・C(0.447→0.469)では KFold の方が高い r を与え、話者リークによる楽観バイアスと整合。本文は全次元で subject-wise split の値を採用。
- 反証用ベースライン:条件1(テキストあり)/条件2(要約のみ)/条件3(ランダムテキスト、乱数シード42)を比較。条件3では全5次元でHolm補正後の有意性が消失(robs = −0.120–0.242, pHolm ≥ 0.287)し、陰性対照として機能。
- 設計の検出力:N = 120 は品質基準を満たすレコードの全数採用で、事前の検出力計算に基づくものではありません。そのため実データの説明変数行列と話者グルーピングを用いて検出力を別途見積もりました。α = 0.05 では母集団重相関 ρ = 0.349 で検出力50%、ρ = 0.438 で80%(臨界値 rcrit = 0.250)。小さい関連は検出できない設計であることを開示しています。
主結果
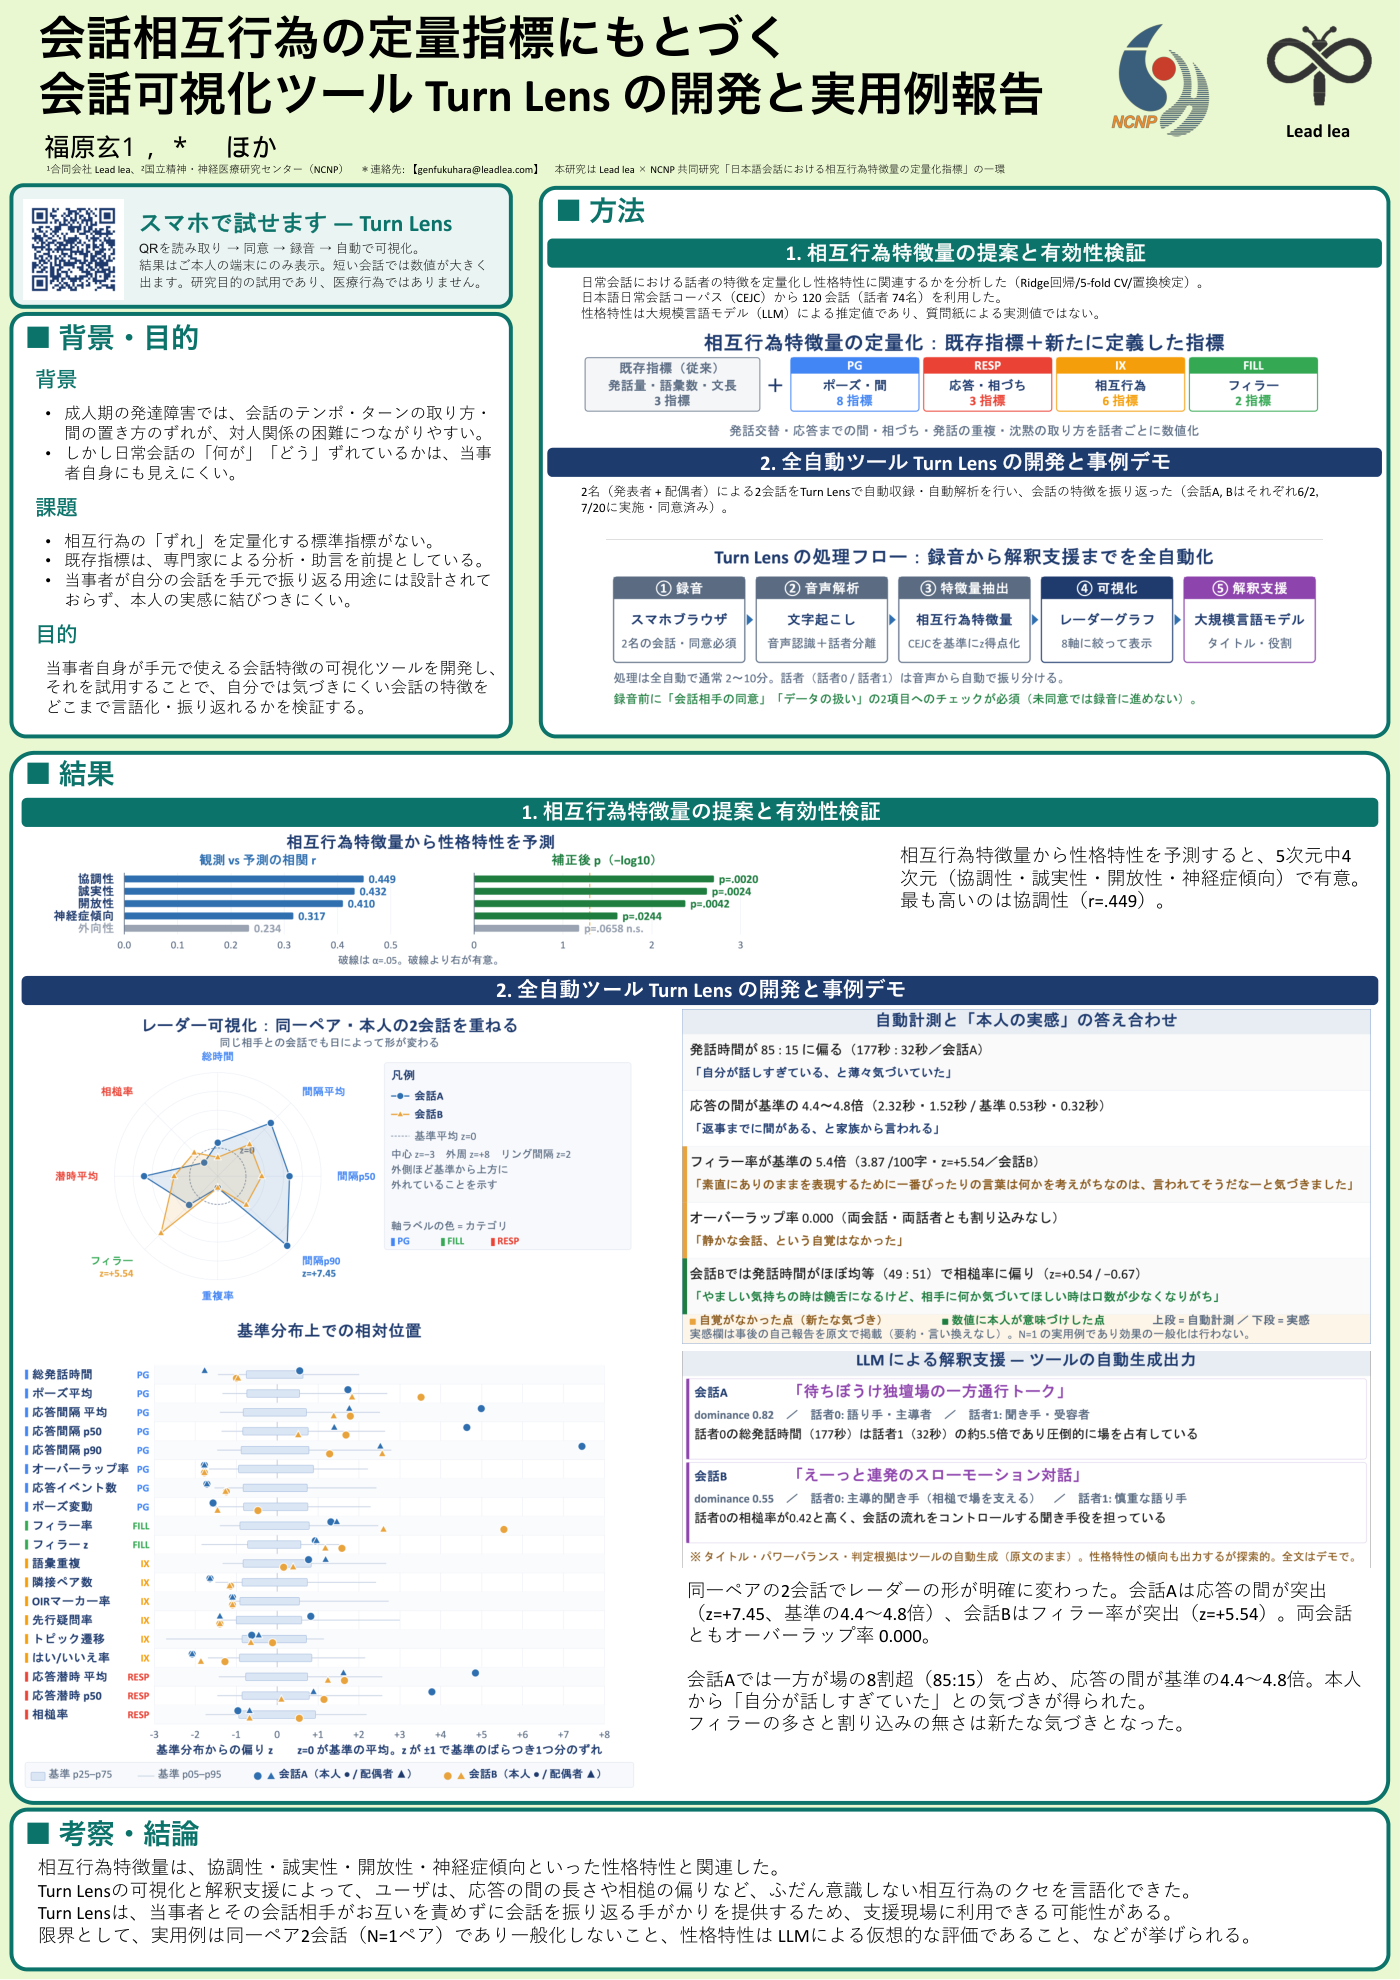
相互行為特徴量(+性別・年齢)から仮想Big5スコアを予測した置換検定の結果。Holm補正後、5次元すべてで有意でした(rfold = 0.254–0.517)。ただし決定係数は 0.072–0.182 で、示しているのは関連の存在であって予測精度ではありません。
掲載しているのは査読を経ていない論文原稿(2026年9月30日改訂版)の要約値です。投稿・査読の過程で数値や記述が変わる可能性があります。引用や追試のご相談は本人までご連絡ください。解析対象のコーパス(CEJC)は第三者がライセンス配布するものであり、本ページには転記データ・派生データ・発話の引用を一切掲載していません。
| Big5 次元 | rfold | R²oof | p(補正後) | 判定 |
|---|---|---|---|---|
| A — 協調性 | 0.517 | 0.126 | 0.0020 | * |
| C — 誠実性 | 0.447 | 0.182 | 0.0020 | * |
| N — 神経症傾向 | 0.406 | 0.079 | 0.0030 | * |
| O — 開放性 | 0.401 | 0.154 | 0.0030 | * |
| E — 外向性 | 0.254 | 0.072 | 0.0472 | * 判定保留 |
「関連がある」までで、予測精度ではない
R²oof は 0.072–0.182 にとどまり、RMSE は目的変数のSDをわずかに下回る程度(A では RMSE = 0.240 に対し SD = 0.258)。A と N では fold 平均 r と連結後 r の乖離も大きく(A: 0.517→0.366、N: 0.406→0.294)、fold間で系統的なずれがあります。個人のスコアを言い当てる用途には使えません。
寄与する特徴量は次元ごとに違う
置換検定 p < 0.05 かつ Bootstrap 95%CI がゼロを除外した「両手法支持特徴量」は計18個。次元別に 2〜5 個(O: 5、C: 4、A: 4、E: 3、N: 2)で、構成は次元ごとに異なります。間・ギャップ系(PG)は5次元中4次元(O・C・E・A)に寄与する一方 N には寄与せず、新たに定義した連鎖組織系・応答型系は5次元中3次元(C・A・N)で寄与。18個のうち6個が新規特徴量で、N では2個ともが新規(連鎖組織系)でした。修復開始率(無条件)と沈黙長の変動係数は、どの次元でも両手法支持に至っていません。
陰性対照は機能した
テキストと話者の対応関係を崩した条件3(ランダムテキスト)では、全5次元でHolm補正後に有意性が消失(robs = −0.120〜0.242, pHolm ≥ 0.287)。条件1 との差は Δr = +0.234〜+0.526 で、全次元で条件1 が優位でした。LLMのスコアがプロンプトの構造や回答バイアスだけで動いているわけではないことを示します。
個人差は確かに捉えている
コーパス基本情報との関連では、13の特徴量が年齢と有意に相関(重なり率 ρ = 0.500、発話率 ρ = 0.447、フィラー出現率 ρ = 0.442 など)。6つの特徴量で有意な性差も認められました(発話率・沈黙長3指標・フィラー出現発話率・語彙重なり)。有意な関連はタイミング系とフィラー系に集中しています。
Turn Lens:会話相互行為計測ツール
論文の計測パイプラインを、当事者自身が手元で使える形にしたツールです。QRを読み取り、同意、録音、自動で可視化。結果はご本人の端末にのみ表示されます。
成人期の発達障害では、会話のテンポ・ターンの取り方・間の置き方のずれが対人関係の困難につながりやすい一方、「何が」「どう」ずれているのかは当事者自身にも見えにくい。既存の相互行為指標は専門家による分析を前提としており、本人が自分の会話を手元で振り返る用途には設計されていません。
Turn Lens は、この空白を埋めるために作りました。ねらいは診断でも助言でもなく、当事者とその会話相手が、お互いを責めずに会話を振り返る手がかりを持てるようにすることです。
- 実用例
- 発表者+配偶者の2名による2会話(2026年6月2日/7月20日、同意取得済み)を自動収録・自動解析。
- 会話A
- 一方が場の85%を占め(85:15)、応答の間が基準の4.4〜4.8倍(z = +7.45)。「自分が話しすぎていた」との気づきが得られた。
- 会話B
- フィラー率が突出(z = +5.54)。同一ペアでもレーダーの形が明確に変わった。両会話ともオーバーラップ率 0.000。
- 新たな気づき
- フィラーの多さと割り込みの無さは、本人が事前に想定していなかった特徴だった。
- 位置づけ
- 研究目的の試用であり、医療行為ではありません。短い会話では数値が大きく出ます。
福原玄1,* ほか(1合同会社Lead lea/NCNP共同研究)
本ポスターは2026年8月時点の解析結果に基づきます。ポスター中の「5次元中4次元で有意」は、その後の改訂で説明変数に性別・年齢を同時投入したことにより「5次元すべてで有意」に更新されました。「最も高いのは協調性」という結論は維持され、値が r = .449 から rfold = 0.517 に変わっています。最新値は上の表をご覧ください(2026年9月30日改訂版・査読前)。 クリックで拡大
関心領域
会話相互行為の定量化
ターンテイキング、応答潜時、同調。質的に記述されてきた現象を、再現可能な数値として扱う。
計算論的精神医学と成人発達支援における計測
支援現場で当事者自身が使える計測とは何か。診断ではなく、振り返りの手がかりとしての指標。
再現可能な評価設計
リーク統制、多重比較補正、感度分析。結果を強く見せる設計ではなく、結果を疑える設計。
LLMを測定器として使うこと、およびその妥当性の限界
LLMは何を見て採点しているのか。モデル間一致度、内的一貫性、陰性対照で測れる範囲を確かめる。
限界
言えることと言いすぎなことを分けます。現時点で明示すべき限界は以下です。
- 本ページの数値は査読を経ていない論文原稿(2026年9月30日改訂版)の要約です。投稿・査読の過程で変わる可能性があります。
- Big5スコアは4つのLLMによる推定値(仮想Big5)であり、質問紙による実測値ではありません。人間の性格評定とどこまで一致するかは検証していません。
- N = 120 は小標本です。正則化パラメータの最適化やより複雑なモデルの適用には足りず、一般化可能性を制約します。α = 0.05 のもとで検出力80%に達するのは母集団重相関 ρ = 0.438 以上であり、小さい関連は検出できません。
- 分析対象はCEJCの自宅・2者間会話に限定した120レコード(66会話・74話者)。別コーパスや別の収録条件での外部検証は実施していません。場面・関係性を越えた一般化は主張しません。
- 5次元すべてで有意になったことは、各次元に固有の関連があるというより、発話量に代表される一般因子が複数次元へ共通に寄与している可能性を示します。実際に発話率と沈黙系指標は3次元以上に寄与しており、次元間の弁別性の検討が必要です。
- 係数レベルの検定は21変数×5次元に対する探索的スクリーニングであり、多重比較補正を適用していません。置換検定とBootstrapの一致を判定規則としていますが、これは補正の代替として理論的に保証されたものではなく、同定された特徴量は追試を要する仮説として扱うべきものです。
- 外向性(E)は補正後 p = 0.0472 と有意水準の直下で、α = 10 では有意水準に達しません。E については関連の有無の判定自体を保留しています。E の両手法支持特徴量は沈黙系3指標に限られ、声量・話題導入・笑いなどを捉える指標が不足しています。
- 交絡統制はRidgeの説明変数に性別・年齢を加える形で行っており、非線形の交絡や未測定変数による残差交絡は除去できません。出身地(方言)・職業などの社会的属性との関連も検討していません。
- 74名中25名が2件以上の会話に参加しており(71レコード、全体の59.2%)、CVはGroupKFoldで直接のリークを防いでいますが、相関分析とBootstrapは同一話者の複数レコードを独立として扱っています。標準誤差を過小推定するバイアスが生じえます。話者内安定性(ICC)の検証は今後の課題です。
- 予測値の分布はいずれの次元でも y = x より傾きが小さく、観測値の範囲に対して予測値の範囲が狭いという縮小傾向があります。
- ベースライン検証の条件2(要約のみ)は予想に反して全5次元で有意でした。ただし Cronbach's α が 4モデル平均で 0.041–0.298(条件1 は α ≥ 0.78)まで落ちており、入力情報が乏しいときにLLMが表層量へ強く依存することを示す結果と解釈しています。
- Turn Lensの実用例は同一ペア2会話(N = 1ペア)であり、一般化しません。研究目的の試用であり、医療行為ではありません。
- 本研究は「性格推定」ではなく「相互行為の再現可能な計測」を報告するものです。各指標はタイムスタンプ付き発話表から明示したアルゴリズムで計算され、人手コーディング工程を持たず、かつ特定可能な会話行動を名指します。Big5との関連分析は、この計測道具の妥当性を検証する手段であり、妥当性の根拠は性別・年齢と仮想Big5という限られた基準に留まります。
論文・発表
会話相互行為の定量指標にもとづく会話可視化ツール Turn Lens の開発と実用例報告
第13回 成人発達障害支援学会 高知大会(一般演題・ポスター、2026年7月28日 採択通知)
大会情報を見る日本語日常会話における相互行為特徴量の定量化指標の提案とその妥当性検証
日本語会話コーパスにおける、体系的な相互行為特徴量の提案・検証研究。英語版は本文53ページ(図4点・表5点、付録Aに正則化パラメータの感度分析、付録Bに検出力の見積り)+補足資料24ページ(S1–S8:データ選定、LLM採点手順、相関表、係数詳細、モデル間一致度、ベースライン3条件、特徴量定義のマッチング文字列)。査読前の原稿です。本文・図表・解析データはこのサイトでは公開していません。
解析コードと再現手順は公開しています。特徴量の定義、評価設計、図表の生成スクリプト、コーパスなしで動く合成データ、および報告値とコードの突き合わせ(59項目)を含みます。
Lead lea × NCNP 共同研究「日本語会話における相互行為特徴量の定量化指標」
2025年10月29日に承認、11月4日に共同研究契約を正式締結。研究リード:福原玄(合同会社Lead lea)。共同研究者はNCNP神経研究所所属の研究者。
略歴
研究は本業の外から始まりました。実装と運用の経験が、測れる指標を設計する土台になっています。
2026.09
論文原稿を改訂し、英語版(本文53ページ+補足資料24ページ)に再構成。性別・年齢を主モデルに同時投入して交絡を統制し、CV設計比較・設計の検出力の見積りを追加。Big Five 5次元すべてで有意な関連を確認(rfold = 0.254–0.517)。あわせて位置づけを「定量化指標の提案」から「相互行為の再現可能な計測(計測道具の提示)」へ明確化。第13回成人発達障害支援学会 高知大会にてポスター発表(Turn Lens)。
2026.07
論文原稿の初版と再現性検証スクリプトを整備。ポスター演題が採択(7月28日)。
2026.02
株式会社ビジョン・コンサルティング Prime AI 執行役員 兼 CAIO 就任。
2025.11
NCNP共同研究者に。「日本語会話における相互行為特徴量の定量化指標」の研究リードを務める。
2025.06
AWSジャパン生成AI実用化推進プログラムに採択。
2025.03
感情解析×実世界型XAI「感響AI®」を提供開始。コア技術を特許出願(特願2025-040035、2025年3月13日出願)。2026年9月29日に特開2026-151292として公開、審査中。商標登録第6956648号。
2024.06
AWS Summit Japan 2024 登壇。Amazon Bedrockによる波情報自動文書化の社会実装事例を発表(文書化コスト80%削減)。
2023.03–2025.03
株式会社ファーストトレード CTO。ヘルスケアSaaSと生成AI導入を推進。
研究の外で
研究と実装のほかに、身体を使って続けてきた仕事があります。どれも同じ人間の経験なので、ここにまとめておきます。
サーフィン歴40年
湘南・大磯を拠点に、マンツーマンのサーフィンレッスンを行っています。HOTLINE ウェットスーツ正規ディーラー歴20年以上。Amazon Bedrockによる波情報の自動文書化(AWS Summit Japan 2024登壇)は、この経験と実装の仕事が重なった事例です。プライベートサーフィンレッスン →
フレンチトースト専門キッチンカー10年
2012年に開業し、2021年に事業を譲渡するまでに740回以上出店しました。メディア掲載・出演は36件。卵・乳製品を使わないメニューの開発を続け、現在は出張ケータリングとして再開しています。フレンチトーストの出張ケータリング →
ヴィーガンの食生活とからだづくり
動物愛護の観点からヴィーガンの食生活を選び、20年以上セルフケアを続けています。腸脳相関とからだづくりを講演テーマのひとつにしています。講演テーマを見る →
コピーライター・川柳家(波上カケル)
2002年にコピーライターとして仕事を始めました。中小企業診断士川柳(令和2年度)と恋にちなんだ俳句(第12回)で最優秀賞、短編はTOKYO FMラジオドラマ原案募集で入選し、文芸社の書籍に収録されています。いずれもChatGPT登場前の、生成AIを使わない作品です。言葉の仕組みを知りたくて語用論にたどり着いたことが、会話を測る今の研究の出発点です。制約の中の言葉 →
共同研究のご相談
共同研究・データ共有・追試のご相談を歓迎します。
指標定義や再現スクリプトについてのご質問も、お気軽にどうぞ。
福原玄(Gen Fukuhara)
合同会社Lead lea CTO / NCNP共同研究者 / ビジョン・コンサルティング Prime AI 執行役員 兼 CAIO
〒259-0111 神奈川県中郡大磯町国府本郷461-5